笔记
吴恩达深度学习第二课笔记
整理正则化、初始化、梯度检查、优化算法与超参数调试等深度网络训练实践。
展开目录
Course 2: Improving Deep Neural Networks: Hyperparameter tuning, Regularization and Optimization
week 1: Practical Aspects of Deep Learning
- 训练深度学习模型是一项 empirical 的任务:
- 传统机器学习由于数据量比较小, 通常将数据分成 7:3 这样的 train/test 集, 或 6:2:2 这样的 train/dev/test 集; 但深度学习由于用到大量的数据, 不必为 dev 或 test 分配太多的数据, 应将绝大多数数据用于 train, 因此一般性的数据划分可以是 98:1:1 或 99.5:0.4:0.1 这样的.
- training set 与 dev/test 的数据分布可以不一样, 但务必确保 dev 与 test 的数据具有相同的分布.
- 设立 dev 的目的是, 从训练得到的多个模型中找到最优的模型, 而 test 的目的是检验选择的模型的泛化能力. 因此可以不要 test set. 上述的 train/test, 更确切的说法应为 train/dev.
高偏差 high bias对应欠拟合 underfit,高方差 high variance对应过拟合 overfit.- 训练误差远高于
人类水平 human level, 意味着高偏差, 欠拟合; 检验误差与训练误差很大, 意味着高方差, 过拟合. (对于某项任务, 人类误差也很大的情况下, 训练误差很大, 但接近人类水平, 不称为欠拟合) (训练误差与人类水平 (误差) 之间的差距, 吴恩达老师称为可避免偏差 avoidable bias) - basic recipe for machine learning
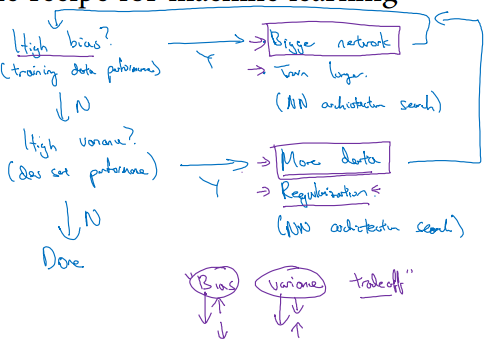
- 如上图所示, 首先要保证 low bias (考究的是训练集的性能), 如果偏差很大, 尝试更大的神经网络, 比如训练更长时间, 修改模型; 在保证了 low bias 之后, 要检验 variance, 即验证集的性能, 如果方差很大, 可以尝试更多的验证数据, 或者通过
正则项 regularization引入惩罚. 最终得到低偏差低方差的模型 - 减小偏差的技术, 可能会引起方差增大; 反之亦然. 这称为
偏差-方差平衡 bias-variance trade-off - 正则化, 实际上是引入了对参数 (w, b) 的新的限制. 比如增加了 L2 正则项的成本函数, 最小化成本函数, 所求的是 L2 范数限制下的参数. 以下是一张很好的示意图:
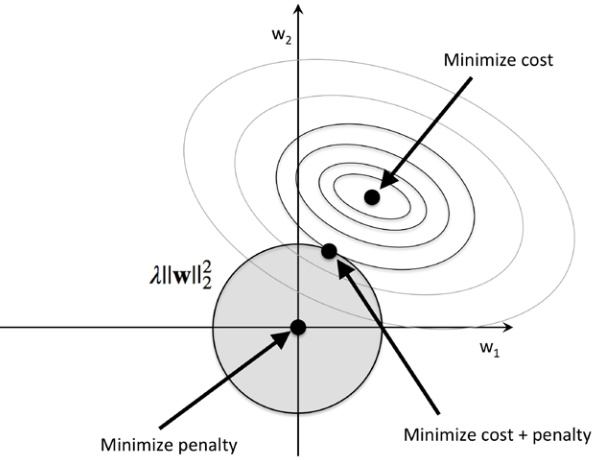
图片截自"Python Machine Learning - Sebastian Raschka"
- 上图中以交点作为最优的参数值的数学依据是: $$a+b>=2 \sqrt{ab}, 当且仅当 a=b 时, 等号成立$$
- 添加 L1 正则项, 将得到稀疏向量 (可用于特征选择), 示意图如下:
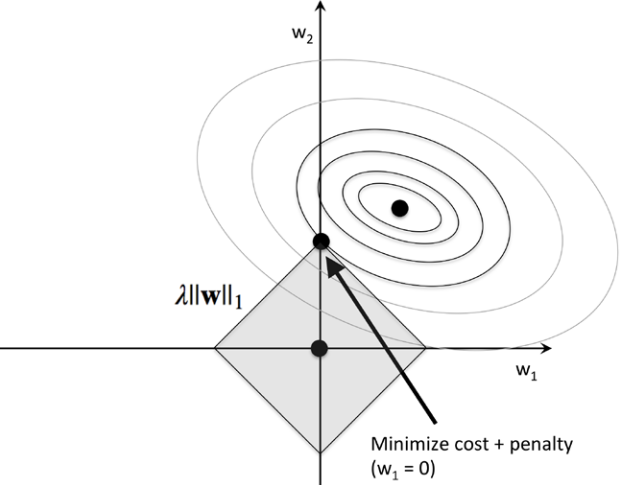
图片截自"Python Machine Learning - Sebastian Raschka"
L2 正则化有时候也被称为weights decay (权重衰减). 因为在添加了 L2 正则项的情况下, 反向传播时, $$dW^[l]$$ 也多了一项 $$\lambda \frac{W^{[l]}}{m}$$. 权值更新如下所示. $$1-\frac{\alpha \lambda}{m} < 1$$,weights decay因此得名:
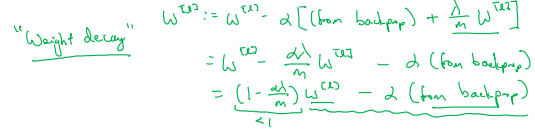
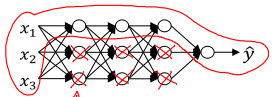
- 正则化能够防止过拟合, 一个理解角度是: 添加了正则项之后, 模型将更偏好于较小的权值. 假设正则化系数 $$\lambda$$ 足够大, 那么权值将趋向于 0, 这相当于闭掉了一些神经元, 模型更简单了, 由参数确定的分割超平面更平滑.
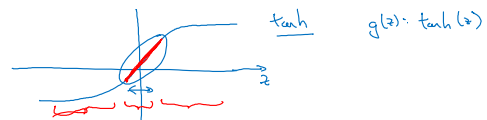
- 正则化能够防止过拟合, 另一个理解角度是: 以 tanh 激活函数为例, 随着正则化系数 $$\lambda$$ 增大, 权值 $$W^{[l]}$$ 减小, 则 $$z^{[l]}=W^{[l]}a^{[l-1]}+b^{[l]}$$ 也减小 (暂时忽略 b), 对于 tanh 函数而言, 在 z 较小的情况下, 函数几乎是线性的. 大量线性单元构成的神经网络, 也可以简化为一个线性模型. 由此, 正则化后的分割超平面也就更平滑了, 防止了过拟合.
Dropout regularization对每个样本进行训练时, 每一层的每个神经元都以一定概率关闭, 这样每次训练都得到一个较小的神经网络, 以这个较小的神经网络对样本进行学习, 从而起到正则化的作用.- 一种最常用的 Dropout regularization 是
Inverted Dropout: 该算法对每一层, 首先随机初始化一个与 a 大小相同的向量, 根据每个元素与固定概率 k 的关系, 得到一个布尔向量 d (或者说 0-1 二值向量), 然后原激活函数值向量 a 乘以 d, 得到新向量 a, 由于 d 中存在 0 元素, 原 a 向量中的元素乘以 0, 结果还是 0, 相当于被屏蔽了. 最后为了保持该层输出不变, 变换后的 a 向量除以 k, 弥补“屏蔽”带来的损失. - 不同于一般的正则化, Dropout regualarization 只在训练时使用, 测试预测时, 不使用.
- 对于 Dropout regularization 防止过拟合的一种理解是: 任一特征都是不可靠的, 每次都对上一层所有输出的特征进行学习是很勉强的 (reluctant), 因此, 每次关停某一层的一些神经元, 下一层神经元的输入就减少了, 从而避免了对不可靠 (以随机概率走远) 特征的学习, 从而避免了过拟合.
- 与 L2 正则化类似, Dropout regularization 起到了 shrink weights 的作用, 关停上一层某一神经元, 相当于其对应的权值也无效了.
- Dropout 正则化, 可以为每一层独立设置
保留 (神经元) 概率 keep probability, 增加了灵活性. 对于很可能会过拟合的层, 可以设置较小的 keep_prob. 一般不对输入层进行 drop out. - Dropout 正则化的一个缺点是, 很难去定义成本函数 J, 因为每次都随机关停了一些节点. 对此, 比较好的做法是, 在执行 Dropout 正则化之前, 先观察成本函数随时间的变化, 确保无误之后, 再进行 Dropout 正则化.
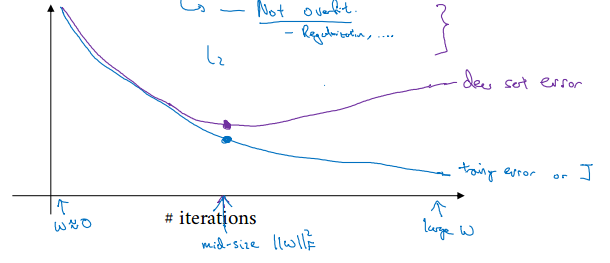
数据增强 Data augmentation是一种在需要更多训练数据时, 可以采取的技术手段. 它对现有的一份样本, 进行一定程度的变换 (比如图片的对称变换, 旋转变换), 得到新的样本.早停 early stopping也是一种防止过拟合的技术手段. 训练开始时, 训练误差和检验误差都随着迭代的进行而下降, 训练误差理论上会持续下降, 而检验误差在达到某一最小值之后, 随着迭代的继续, 反而会上升. 此时, 应在检验误差达到最小值的时候提前结束迭代, 这就是 early stopping.
正规化 normalizing将不同尺度的特征缩放到同一尺度 (每个样本都减去样本均值, 再除以样本方差), 比如 [0, 1] 或 [-1, 1] 的范围. 带来的一个好处是, 使梯度下降算法更快收敛. 直观的感受, 如下图所示
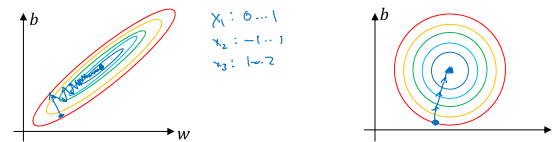
梯度爆炸/消失, vanishing/exploding gradients: 对于一个非常深的深度神经网络, 忽略 b, 仅考虑参数 w, 当每一层的权值都略大于 1 或单位矩阵, 前向传播到最后, 激活函数值将爆炸 (因为指数级增长); 当每一层的权值都略小与 1 或单位矩阵时, 到最后, 激活函数值将无限小 (指数级衰减). 这从一方面证明了随机初始化参数的重要性.- 对于单个神经元, $$z=w^\mathrm{T} x+b$$, 一个直观的感觉, 输入特征数 n 越大, z 也会越大. 为了防止 z 过大或过小, 一种方式是选择更小的权值, 通常的做法是, 初始化权值时, 使权值的方差 $$Var(w_i)$$ 等于一个较小的值, 比如 $$\frac{1}{m}$$:
- 对于 ReLU 激活函数, 权值通常初始化为:
np.random.randn(shape) * np.sqrt(2/n) - 对于 tanh 激活函数, 权值通常初始化为:
np.random.randn(shape) * np.sqrt(1/n). 也称为Xavier 初始化 - 另外还有一种权值初始化的方式是:
np.random.randn(shape) * np.sqrt(2/(n + o))其中 o 为输出特征数
- 对于 ReLU 激活函数, 权值通常初始化为:
- 所谓
梯度检查 gradient checking, 就是检验微分是否正确. 通常的做法是, 利用极限原理, 设 g(theta) 是 f(theta) 的导数, 则梯度检查就是验证 $$\frac{f(\theta + \epsilon) - f(\theta)}{\epsilon}$$ 近似 $$g(\theta)$$, 或者用 $$\frac{(\theta + \epsilon) - f(\theta - \epsilon)}{2\epsilon}$$, 能获得更高的精度. 一般而言, 误差在 $$10^{-7}$$ 以内的, 表明微分没问题; 误差在 $$10^{-7} ~ 10^{-5}$$ 的, 可能有点问题; 误差在 $$10^{-3}$$ 的, 很有可能微分出错了. - Gradient Checking 的一些注意点:
- 只在调试的时候用, 训练时不需要
- 梯度检查失败, 说明算法肯定存在问题
- 别忘了正则化
- 梯度检查对 Dropout 无效, 因为 Dropout 随机关停神经元, 很难对成本函数进行定义
- 随机初始化
week 2: Optimization
小批量梯度下降, MBGD, minibatch_size=1 时, 就是随机梯度下降算法; mibibatch_size=训练集容量 m, 就是批量梯度下降算法.- SGD 收敛很快, 但它实际无法利用向量化带来的计算加速, 它的快只是因为它每次以一个样本来执行梯度下降算法
- 实际应用中, minibatch_size 通常不取 1, 也不取 m, 通常取 $$2^n$$, 以适应内存或显存的需求, 但不取太大的值
指数加权平均 Exponentially weighted averages, 有时候也称指数加权移动平均, 引入过去对现在的影响, 而不单单考虑当前值, 因此可以抚平短期波动, 反映出长期的趋势. 其公式是: $$v_t = \beta v_{t-1} + (1 - \beta) \theta_t (v_0 = 0)$$. 其中 $$\theta$$ 是原始变量, v 是对 $$\theta$$ 进行了指数加权平均得到的变量, $$\beta$$ 是不知名系数, 用于控制平均的量, $$\beta$$ 的值越大, 将计算之前越多数据的平均, 一般默认取 0.9- 由于 $$v_0 = 0$$, 指数加权平均刚开始计算时, $$v_t$$ 与 $$\theta_t$$ 偏差很大.
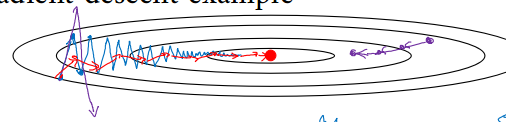
bias correction用于解决该问题, 做法是, 计算得 $$v_t$$ 之后, 再除以 $$1 - \beta^t$$, 作为最终结果. 动量算法 Momentum, 也称为Gradient descent with momentum, 就是将指数加权平均引入梯度下降算法, 用参数更新量的指数加权平均结果代替参数更新量, 来更新参数. 以 W 为例, 就是先计算 $$v_dW = \beta v_dW + (1 - \beta)dW$$, 然后用 $$v_dW$$ 来更新 W, 即 $$W = W - \alpha v_dW$$. 有时候, 也用 $$v_dW = \beta v_dW + dW$$ 来计算 $$v_dW$$.- 引入动量, 能加速梯度下降的收敛, 可以用下图来说明. 使用 MBGD 时, 由于不能得到全局最优解, 梯度下降的过程是曲折的, 但大方向是向全局最优解靠近的 (这一点很重要), 可能如图中蓝色曲线所示 (极端例子). 使用指数加权平均之后, 不是向最优解靠近的移动量 (图中竖直方向) 相互抵消, 而向最优解靠近的移动量持续叠加, 就得到了图中红色曲线. 下图比较直观地展现了动量对梯度下降的加速效果.
RMSprop (Root Mean Square prop)与动量算法有相似的地方, 但又不同. 具体地, 以参数 W 为例, 其他参数处理相同, RMSprop 先求 sdW, 这是 dW^2 的指数加权平均值, 然后更新参数时, 使用公式: $$W = W - \alpha * d_W / \sqrt{sd_W+\epsilon}$$. (RMS 由此得名, 对均方 $$sd_W$$ 求根) ($$\epsilon$$ 是为了避免除零之类的错误, 至于为什么再求个根, 我也很好奇).- RMSprop 能加速梯度下降收敛, 解释如下: 对 $$dW$$ 求平方, 首先放大了参数 W 的增大或减小量, 然后求指数加权平均, 累加了增大或减小的效果, 结果 $$s_dW$$ 就是一个极大或极小的值. 假设 $$s_dW$$ 极大, $$\frac{dW}{\sqrt{s_dW}}$$ 就变小; $$s_dW$$ 极小, $$\frac{dW}{\sqrt{s_dW}}$$ 就变大, 从而减轻了梯度下降的震荡, 保证梯度下降的正轨.
- RMSprop 的一个好是, 由于使用 $$\frac{dW}{\sqrt{s_dW+\epsilon}}$$ 减轻了震荡, 就可以使用一个较大的学习率 $$\alpha$$, 加速学习.
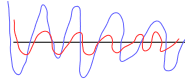
Adam是 Momentum 和 RMSprop 的有机结合, 当然, 计算 $$v_dW$$ 和 $$s_dW$$ 时使用的 $$\beta$$ 是不一样的, 分别记作 $$\beta_1$$ 和 $$\beta_2$$. 最后参数的更新为: $$W = W - \alpha \frac{v_dWc}{\sqrt{s_dWc +\epsilon}}$$. $$v_dWc$$ 和 $$s_dWc$$ 分别是经过 bias correction 的 $$v_dW$$ 和 $$s_dW$$.Adam有 4 个超参数: $$\alpha$$, $$\beta_1$$ (动量算法的 $$\beta$$), $$\beta_2$$ (RMSprop 用到的 $$\beta$$), $$\epsilon$$. 一般而言, $$\beta_1$$ 默认取 0.9, $$\beta_2$$ 默认取 0.999, $$\epsilon$$ 取 $$10^{-8}$$, 只剩下 $$\alpha$$ 需要调节.学习率衰减 learning rate decay对于 MBGD 以及 SGD 相当关键. 原因在于, MBGD/SGD 并不能获得全局最优解, 即使选择了一个能收敛的学习率, 当成本曲折地下降到全局最优解附近时, 由于学习率始终不变, 成本可能会以一个较大的偏差幅度在全局最优解附近震荡. 如下图所示, 相比于蓝色曲线, 我们觉得红色曲线更好, 因为它震荡的幅度更小, 更逼近直线. 学习率衰减就是要让 MBGD/SGD 在收敛至全局最优解时, 尽可能逼近全局最优解, 而不是大幅地徘徊.
- 常用的学习率衰减公式:
- $$\alpha = \frac{\alpha_0}{1 + decay_rate * epoch_num}$$. 每一轮迭代, 都对学习率进行衰减.
- $$\alpha = k * \frac{\alpha_0}{\sqrt{epoch_num}}$$ 或者 $$\alpha = k * \frac{\alpha_0}{\sqrt{t}}$$
- $$\alpha = 0.95^epoch_num * \alpha_0$$. 指数衰减, 底数可以自由地选择小于 1 的数
- 梯度为 0 的点, 不一定是极小极大值点, 也可能是
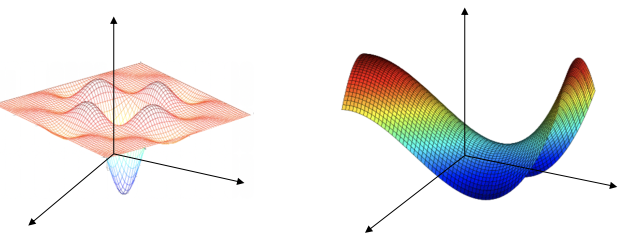
鞍点. 比如 $$y=x^3$$ 在 0 处就是鞍点. 对于深度学习而言, 由于参数数量极大, 在高维空间中, 一般很难得到如下图左图所示的全局最优情况, 往往因为各参数的极值点各不相同, 更多的可能是得到类似下图右图所示的情况, 称为Problem of plateaus. 因为曲面比较光滑, 梯度下降陷入不好的局部最优的可能性变得很小, 但带来的另一个问题是, 微分长期保持在一个极小的值, 致使梯度下降得极慢, 收敛需要相当长的时间.
week 3: Hyperparameter Tuning & Batch Normalization & Programming Frameworks
- 传统机器学习调节超参数时可能会使用
网格搜索 grid search来选择最优超参数, 但对深度学习, 网格搜索的意义不大, 更通常的做法是随机选择超参数值, 然后由粗到细 coarse to fine, 重复随机选择超参数. - 所谓
随机选择, 并不是都采取均匀随机采样. 比如, 对于均匀分布的变量, 可以随机采样; 对于非均匀分布, 比如梯度下降学习率 $$\alpha$$ 的范围是 [0.0001, 1], 比较正确的做法是, 在 (0.0001, 0.001, 0.01, 0.1, 1) 附近进行随机采样, 具体的做法是:r = -4 * np.random.rand()$$a = 10^r$$ 再比如指数加权平均的超参数 $$\beta$$, 范围是 [0.9, 0.999], 一般也认为不是均匀分布的, 此时要利用 $$1-\beta$$ 构造表达式, 首先 $$1-\beta$$ 的范围是 [0.001, 0.1], 此时就可以用上述相同的方法进行构造: $$\beta = 1 - 10^r$$ - 一个经验之谈是: 偶尔 (比如每隔几个月) 重新测试超参数. 理由是, 随着数据量的增多, 过去的模型可能会过时 (stale).
- 深度学习的两种打开方式:
- 熊猫式 (Babysitting one model): 在计算资源有限的情况下, 难于同时训练多个模型, 因此一般精心地训练一个模型
- 鱼子式 (Training many models in parallel): 在计算资源充足的情况下, 可以同时训练多个模型, 最后选择最优的即可
- 我们已经知道对样本输入进行正规化 (减去样本均值, 除以样本方差) 能加速学习.
Batch Normalization是输入正规化的一个扩展: 对每一层的输出 a 也进行正规化. 但更通常的做法是对线性加权的结果 z 进行正规化. - Batch Norm 的具体实现是: 在计算得 z 之后, 根据 $$\mu=\Sigma \frac{z_i}{m}; \sigma ^2=\Sigma z_i - mu$$ 求得 $$z_{norm}$$. 只进行到这一步, 每一层的 z 都具有相同的分布, 均值都是 0, 方差都是 1. 有时候我们并不希望这样, 也许不同的分布会有奇效, 也许我们就是想要不一样的分布. 因此通常还要通过 $$\tilde{z_i}=\gamma z_i+ \beta$$ 来调整 z 的分布. $$\gamma$$, $$\beta$$ 是模型可以学习的参数, 同 W, b 的性质一样.
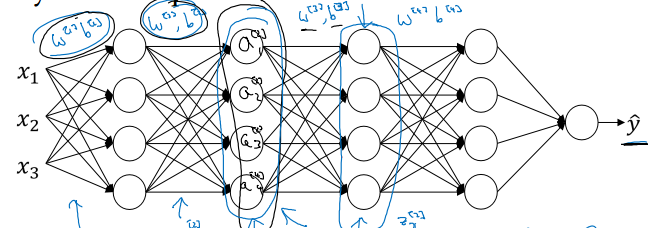
- Batch Norm 有效, 可以用下图来解释. 越是靠前的层次, 对神经网络整体的影响一般越深远, 比如第一隐层的输入发生改变, 则后续的 2, 3, 4, 5 层的输入都要发生改变. 而如果只是第 4 隐层的发生改变, 影响的只是输出层而已. 对下图而言, 先不看输入层与第一隐层, 如果以第二隐层作为输入, 我们已经学好了 W3, b3, W4, b4, W5, b5, 对服从某一分布的输入, 能做出高精度的预测了. 现在重新考虑输入层与第一隐层, 这两层的加入, 会改变第二隐层的输入数据的分布, 后续所有层都不得不以较剧烈的幅度重新学习参数, 相当于重新训练了整个神经网络. 而
Batch Norm增强了神经网络的鲁棒性 Robustness, 就是说, 对第一隐层输出的正规化, 使得第二隐层输入的数据分布保持在一个较稳定的状态, 如果第二隐层已经学好了参数, 现在只需微调甚至不需要调整. 后续各层同样如此.
-
总结一下 Batch Norm 的作用就是:
限制了靠前层次的参数更新对后续层次输入分布的影响, 从而减小了后续层次输入值的变化, 使得后续层次更稳定. 这使得, 前面的层次持续学习, 但后续层次不得不应变的可能性减小了, 也就是说, 解偶了各层次, 或者说弱化了各层参数之间的联系. 于是, 神经网络的各层可以相对独立地进行学习, 对其他层的依赖大大减小了, 加速了整个神经网络的学习. -
如上所述, Batch Norm 的一个副作用是, 提高了神经网络的复用性.
-
Batch Norm 的其他注意点:
- 每个 mini-batch 要独立计算均值与方差, 然后缩放
- 对于每个 mini-batch, batch norm 会给 z 值引入噪音 (类似地, dropout regularization 会给每个隐层的 a 引入噪音)
- Batch Norm 有轻微的正则化效果
-
测试时, 我们每次用一个测试样本来计算误差, 无法像训练时那样拥有一个 minibatch, 然后对 minibatch 计算均值/方差. 典型的做法是, 训练时, 记录每一个 minibatch 在每一层的均值/方差, 如 $$mu^{{1}[l]}, \sigma^2 ^{{1}[l]}$$, 再计算 $$\mu$$ 与 $$\sigma^2$$ 各自的指数加权平均, 作为测试用的 $$\mu$$ 与$$\sigma^2$$. 至于 $$\gamma$$ 与 $$\beta$$, 如前所述, 是同 W, b 一样的参数, 直接用训练习得的即可.
-
选择深度学习框架的几点建议:
- 易于编程 (包括开发和部署)
- 运行速度快
- 真开放 (开源, 且拥有良好的管理. 那些目前开源, 但缺乏管理, 未来可能被闭源的不算真开放)